Kafka
Kafka 개념
backend-dev
2026. 4. 25. 11:40
Kafka를 배워야 하는 이유
주니어 개발자 채용공고를 확인해보면 아래와 같은 우대사항이 점점 늘어나고 있다.
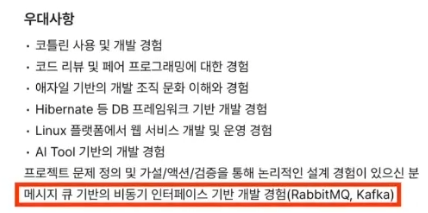
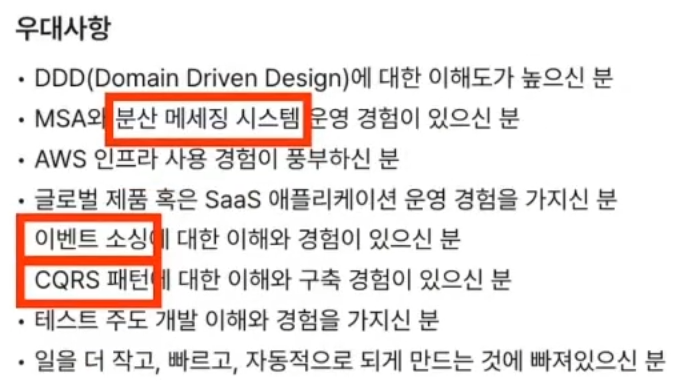
MSA 아키텍처 붐이 일어나면서 Kafka도 같이 붐이 일어났다. 왜 그런걸까?
Kafka를 사용하는 이유를 조사해보았다.
- Pub/Sub 구조를 통해 서비스간 결합도를 낮춰 장애 전파를 막을 수 있다.
- 메시지를 브로커에 저장해 두는 구조로 트래픽이 몰릴 때 버퍼 역할을 수행하여 시스템 과부하를 방지한다.
- 데이터를 디스크에 저장하고 복제를 하여 데이터 유실 위험을 최소화한다.
- Partition 기반 수평 확장이 가능하여 대규모 분산처리가 가능하다
서비스 안정성과 대규모 데이터 처리를 위해 Kafka 사용하고 있다. 한번 빠르게 학습해보고 간단한 프로젝트에 적용해보자.
기본 용어
Kafka란?
대규모 데이터를 처리할 수 있는 메시지 큐
메시지 큐란?
큐 형태에 데이터를 일시적으로 저장하는 임시 저장소. 비동기적으로 데이터를 처리할 수 있어서 효율적
비동기
작업 완료를 기다리지 않고 병렬적으로 처리
REST API vs 메시지 큐
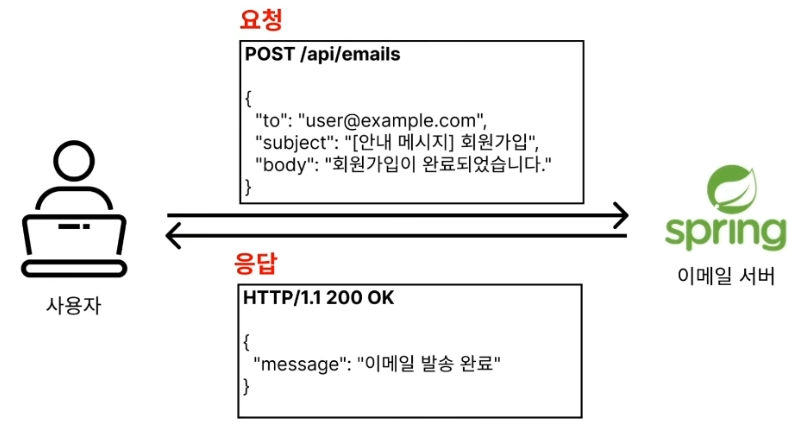
- 사용자가 REST API 요청을 보냄
- 요청 처리
- 성공 응답
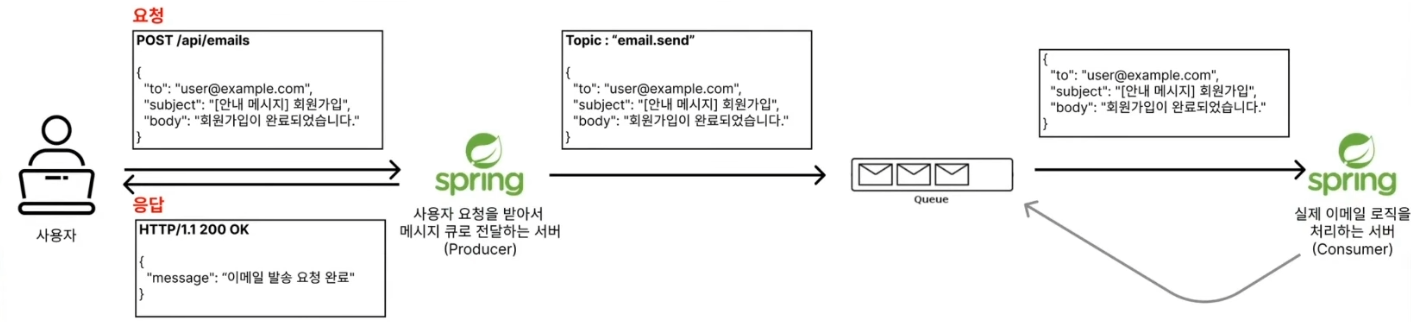
- 사용자가 REST API 요청을 보냄
- 요청을 처리하는 대신 MQ에 저장할 메시지 생성
- 메시지를 큐에 전달하고 사용자에게 성공 응답
- 큐는 메시지를 임시 보관
- Consumer 서버는 큐에 있는 데이터를 꺼내서 직접 처리
Kafka의 기본 구성

Producer : 카프카에 메시지를 전달하는 주체
Consumer : 카프카의 메시지를 처리하는 주체
Topic : 카프카에 넣을 메시지의 종류를 구분하는 카테고리